数字人文与艺术史:当计算机开始读画
Digital Humanities and Art History: When Computers Start Reading Paintings
破除误解
误解
第一个误解,是把数字人文理解为"用电脑加速旧研究"——检索快一点、图像清晰一点,仅此而已。实情真正的变化是提问方式的变化:传统艺术史家一辈子精读几百件作品,计算艺术史可以一晚测量几十万幅图像的色相分布、笔触方向与构图骨架。当样本量从"精读的全部"变成"全集",一些原先不可问的问题——风格的渐变速率、跨地域母题的真实传播路径、经典之外海量无名作品的生态——第一次成为可问的问题。艺术史从一门"例证的学科"部分地变成了"分布的学科"。
误解
第二个误解,是反过来相信"算法终将取代鉴赏家"。实情机器测量的是像素的相关结构,鉴赏家判断的是意图、传统与历史情境;一幅画的风格归属在机器那里是分类概率,在学者那里是关乎时代、师承与材料条件的论证。两者的知识种类不同,混淆它们的后果我们在赝品史上已经看过:任何单一证据被奉为终极裁判,都会被系统性愚弄。真正的分工前景是互补而非替代:算法负责在十万幅图像里圈出值得近看的十幅,鉴赏家负责解释为什么值得。
误解
第三个误解,是认为数字化是中性技术操作:把馆藏扫上网,知识就民主化了。实情扫描什么、以什么精度、配什么元数据、用什么分类体系,每个决定都在重塑未来研究的原料。没有被数字化的作品在算法时代等于不存在——图像库不是艺术史的中性底座,而是一种新的经典编纂权。
历史脉络:从幻灯片库到像素全集
艺术史自始就是一门依赖图像复制技术的学科:没有十九世纪的照片档案与二十世纪的幻灯片库,跨地域的风格比较根本无法进行——马尔罗所谓"想象博物馆"的前提就是复制。数字化是这个谱系的最新一环,但量级跃迁改变了学科的地貌。2011 年上线的 Google 艺术计划把博物馆展厅搬进浏览器;2017 年大都会艺术博物馆启动开放获取计划,把数十万件馆藏高清图像以 CC0 协议释出,任何人都可以下载、测量与再发布;维基艺术(WikiArt)等公开数据集则成为算法训练的标准原料,今天的风格分类论文几乎都以它为基准测试场。
数字的"全集感"来自几个可核对的节点。2011 年 2 月 1 日上线的 Google 艺术计划,第一期只接入 17 家博物馆、一千余件作品,却把展厅街景与单幅约十亿像素的细节同时送进浏览器。2017 年 2 月 7 日,大都会把公有领域藏品图像改挂 CC0:当时一次性放开超过 37.5 万张图,基本著录数据一并开放;此后开放图像继续增长,馆方现称已接近 50 万。原料从此不再只是幻灯片柜里的那一套"代表作"。
可原料仍是被挑选过的。扫描经费、版权状态、馆方认为值得拍摄的名单,共同决定算法能看见什么。没有进入库的作品,在远观里等于零。要把不同馆的高清图拿来对测量,还需要传送协议:国际图像互操作框架(IIIF)让缩放、截取与比对可以跨馆进行。没有共同接口,"全集"只是一堆互不相通的网站。
方法论的自觉发生在 2010 年代。列夫·马诺维奇以"文化分析"(cultural analytics)为名,用可视化方法研究百万级的图像集合;泰勒·阿诺德与劳伦·蒂尔顿提出"远观"(distant viewing),与文学研究的"远读"呼应:不逐幅细读,而以算法测量图像集合的整体形态。深度学习给这套抱负装上了引擎:2015 年,加蒂斯、埃克与贝特格发表的神经风格迁移算法证明,卷积神经网络内部存在可分离的"内容"与"风格"表征——"风格"这个艺术史的百年概念,第一次在机器内部获得了可操作的形式对应物。2018 年,艾哈迈德·埃尔加迈勒团队的论文《机器眼中的艺术史形状》用网络自动学习到的特征重建风格演化序列,发现机器给出的风格相邻关系与艺术史家公认的谱系惊人吻合——也不乏系统性的出入,而那些出入正是新的研究问题:机器认为相邻而学界认为疏远的风格对,往往指向被教科书叙事压平的过渡地带。
远观的文学孪生是莫雷蒂所谓的远读:不逐页精读,而以计算测量一个时代的小说总体。艺术史的远观几乎是同一方法换了媒介——把"风格"从形容词改写成可比较的向量。差别在于,画比文字更早拥有大规模图像库,也更早暴露库本身的偏见。
核心机制:机器如何"看"风格
计算艺术史的工作流大致有三层。测量层把图像转化为特征:色相直方图、笔触方向场、复杂度指标,或直接交给卷积网络学习抽象表征。模式层在特征空间里做统计:聚类、降维、时间序列分析,风格不再是形容词而是高维空间里的几何结构。解释层——也是最脆弱的一层——把统计结构翻译回艺术史语言:这一簇为什么对应"北方风格",那段漂移是趣味变迁还是材料更替。
传统形式分析一次只盯一件作品的构图、色彩与笔触;远观把同样的形式要素变成分布。色相直方图可以告诉你某十年的调色盘整体偏暖,却不能告诉你那是颜料进口中断,还是趣味转向。图像志要问母题的含义,像素统计只问母题出现的频率。两套问题都合法,只是不能互相冒充。
还有一支研究把量化对象从画面内部转向艺术界的结构本身:用展览记录重建艺术家的流动网络,用拍卖与收藏档案测量趣味传播的速率,用网络分析检验"艺术中心"的历史转移。这类"艺术界社会学"的量化复兴把贝克尔的定性洞见变成了可测量的命题:哪些机构是风格扩散的枢纽、边缘艺术家进入中心需要经过哪几道门——艺术史的宏观叙事第一次有了网络科学的对照组。
把测量落到画布纤维上,归属才有了不太爱吹牛的证据。康奈尔大学的约翰逊(C. Richard Johnson, Jr.)与莱斯大学的唐·约翰逊等人发展出自动数线:先给画布拍 X 光,再由算法绘制经纬密度图,匹配同一匹布上切下来的不同画心。
2011 年前后,他们已处理梵高博物馆全部约 320 幅藏画,并扩展到其他馆藏;2012 年 2 月《伯灵顿杂志》的合作论文称当时已分析逾 380 幅画布。织纹对得上,往往能把存疑的创作顺序推回同一段工作季。它回答的是"这两张是不是同一卷亚麻上的邻居"——正是归属与来源与保护科学的交汇点。
计算归属其实是莫雷利方法的数字后裔。十九世纪的莫雷利不看主题——那是作伪者最用心模仿的部分——而看耳朵轮廓、指甲与衣褶这些无意识习惯。算法做的是同一件事:在人眼会忽略的统计指纹里找作者。差别在于,机器可以同时处理十万只耳朵,却仍然无法独自宣布"这就是伦勃朗"。
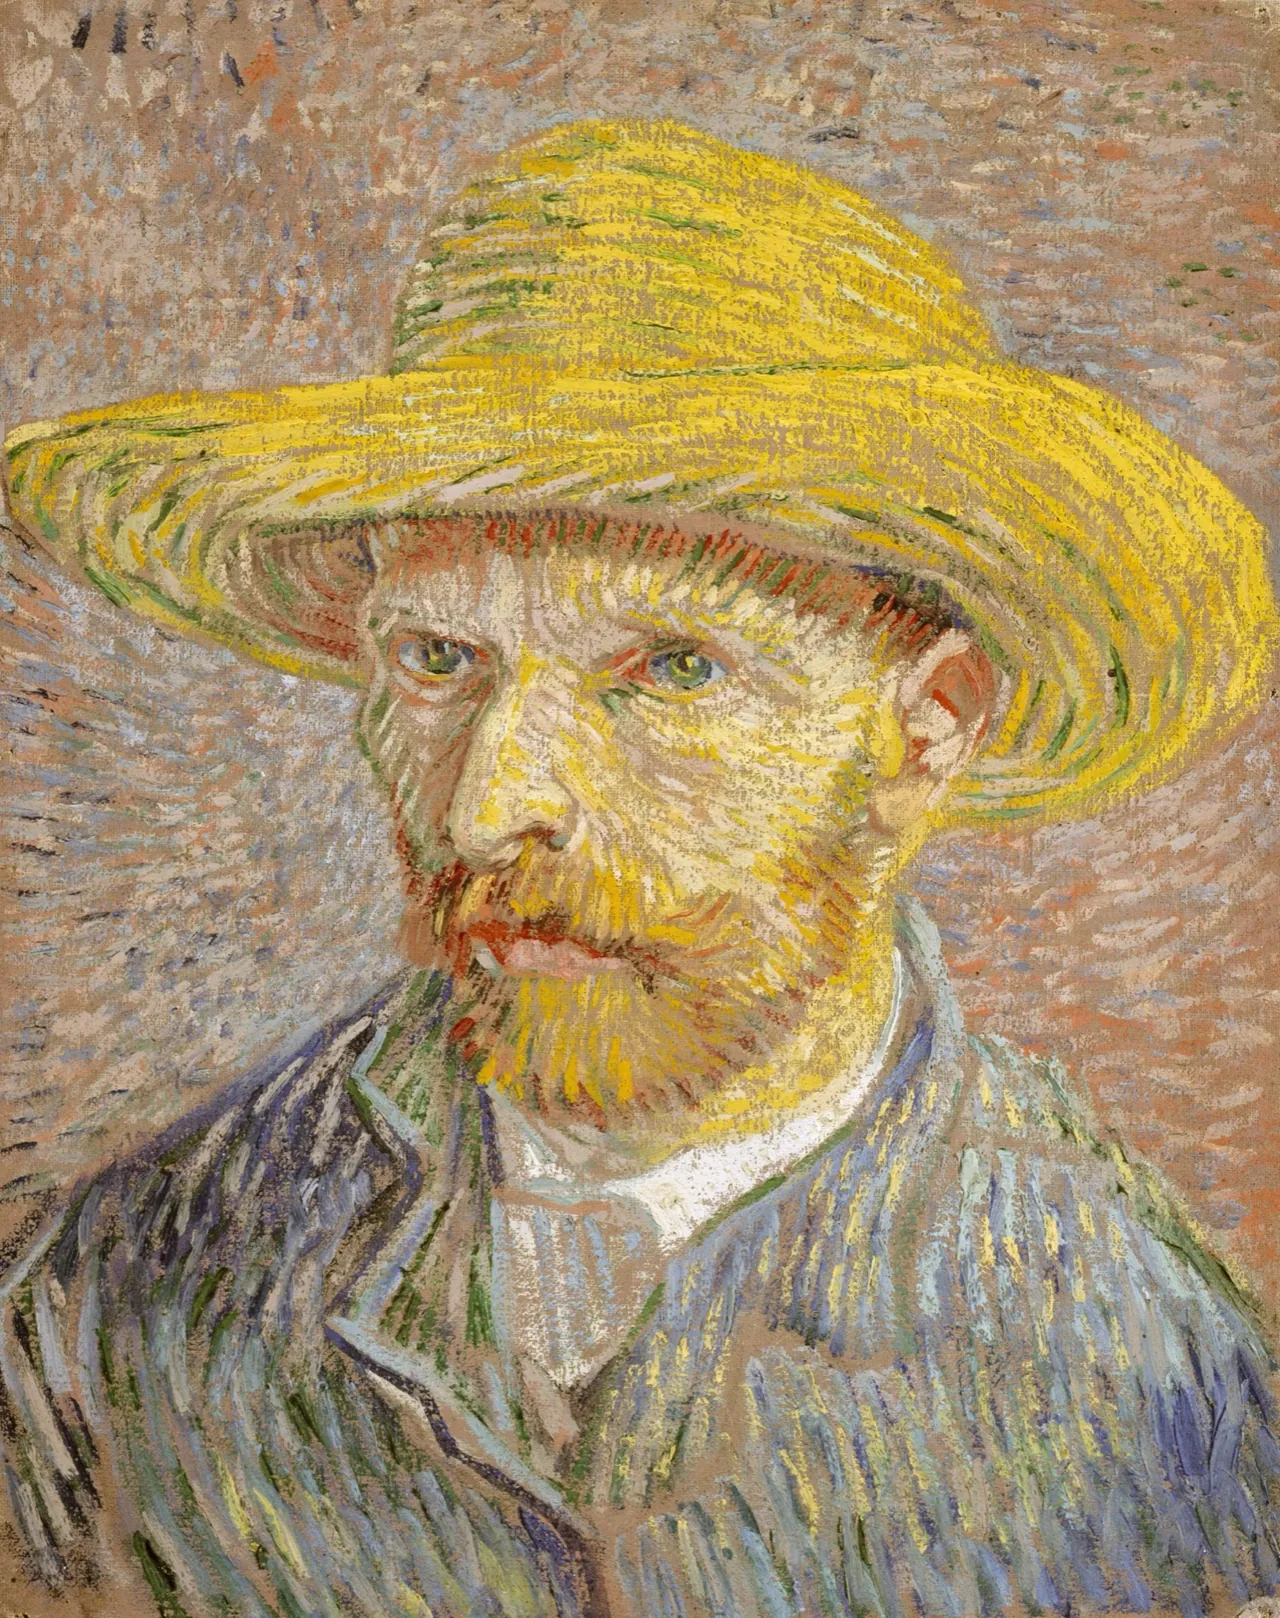
归属研究是最诱人的应用。笔触的统计指纹、画布织纹的线数分析、网络输出的相似度分数,都已被用于辅助判断传习作品的归属——研究者曾用织纹比对把分散的梵高画布重新归并到同一匹布料的序列中,这类"物质指纹"的匹配为归属争论提供了难得的硬证据。凡·高的自画像是这类研究的标准试验场:同一画家、同一题材、同一时期的系列作品,为算法的校准与验证提供了近乎理想的控制组。
2016 年的"下一个伦勃朗"项目把这条路线推到公众面前:团队分析了三百余件伦勃朗画作的扫描数据与十余万个局部特征,让算法生成了一幅"典型伦勃朗式"的新肖像并以 3D 打印模拟笔触厚度。更具体的生成指令来自统计:算法被要求画的是一名三十至四十岁、蓄须、黑衣白领、戴帽、面朝右侧的男子——因为存世肖像里这一类最多,数据最密。打印用了十多层紫外固化墨水去模拟颜料堆积,而不是一张光滑的海报。
它轰动一时,也暴露了方法的天花板:算法擅长的是统计上的"典型",而杰作的价值往往在于对典型的偏离——伦勃朗之所以是伦勃朗,恰恰在于他晚年的笔触背叛了自己中年确立的规则。
争议与边界
计算艺术史的批评者指出一个结构性风险:算法的训练集就是被数字化的经典。西方经典在图像库中过度代表,非西方与无名作品欠代表,算法学到的"艺术史形状"不过是馆藏偏见的自画像。远观的许诺是看见全集,但"全集"的边界由数字化经费与版权划定——这让计算研究可能不是消解而是固化经典。数据库的元数据同样携带立场:分类字段沿用十九世纪欧洲画派的范畴,非西方作品被塞进借来的格子,检索系统便日复一日地把旧经典再生产为新数据。
克莱尔·毕肖普 2018 年的《反对数字艺术史》把批评说得更刺耳:把可计算当成可研究,会把艺术史改写成围着数据集转的技术报告。约翰娜·德鲁克则从另一侧提醒——可视化不是中性的窗户,坐标轴、色标与聚类的形状本身就是解释。机器给出一张"风格地图",等于又写了一份叙事,只是这份叙事穿着科学的外套。
方法论之争同样尖锐。传统学者质疑:风格的统计相关不等于艺术史的解释,机器说"这两幅相近"无法替代"为什么相近"的论证;可解释性的缺失让算法结论难以进入学术辩论。计算阵营则回应:人文学者的论证从来不排斥新的证据形式,问题只在于证据是否可复核——而算法的测量恰恰是最可复核的证据。可复核性同时也暴露了自身的窘境:许多计算论文不公开代码与数据,不同团队在同一数据集上得到不同结论,人文学界尚未建立起评估这类研究的同行评议标准。更有生产力的立场是把机器当作假说生成器:聚类里的异常值、时间线上的突变点,为细读提供新的靶点;远观发现问题,近读裁决问题。
为什么今天仍然重要
艺术史是所有人文计算研究的天然试验场:图像数据丰富、标注传统深厚、判断标准相对收敛。在这里走通的"远观+近读"协作范式,正在被历史学、文学与音乐学借用。这门学科还提供了一种独特的公民技能:当营销稿宣称"AI 读懂了伦勃朗"时,受过训练的眼睛能立刻拆开其中的修辞——机器测量的是它所能测量的,新闻标题把它写成它所想暗示的,两者的缝隙就是这门知识存在的地方。同时,这门学科也站在一个自我反身的位置:生成式 AI 用艺术史的图像库学会了造图,数字人文则要反过来研究这些机器图像如何改写视觉文化——研究对象与研究工具正在合流。理解计算机如何读画,是理解机器视觉时代的前提;而当社会把越来越多的"看"外包给算法,艺术史家对观看的长期训练忽然成了稀缺的公共知识。
生成模型把这个问题从学术圈拖到了公共领域。生成艺术与 AI所依赖的训练图,很大一部分正是博物馆开放获取与 WikiArt 这类库。数字人文若不去追问库的构成,就等于把新的视觉文化建立在未加审查的旧经典之上。
跨域连接
- 计算机视觉:计算艺术史是计算机视觉的人文分支:特征提取、表征学习、相似度度量的全部工具来自 CV 工具箱。反过来,艺术图像也为 CV 提出了独特难题——跨媒介的风格恒常性、数百年退化的干扰、极少样本的细粒度分类。
- 卷积神经网络:神经风格迁移的技术核心正是 CNN 的中间层表征:浅层捕获笔触纹理,深层捕获构图内容,两者的可分性是加蒂斯算法的全部秘密。理解这个架构细节,才能理解"机器眼中的风格"到底是什么、不是什么。
- 机器学习概述:计算艺术史的全部承诺与全部陷阱都是机器学习的通性:模型拟合训练分布,训练分布反映数字化与馆藏偏见,"算法发现了艺术史的规律"与"算法复述了经典的偏见"可以是同一个结果。理解监督学习的基本机制是评估这类研究的前提。
- 数字人文与大数据史学:历史学经历了同一轮转型:从精读档案到全文检索与量化分析,从"典型证据"到"全集证据"。艺术史的远观争论几乎是大数据史学争论的镜像——两个学科在方法论上的互相校验,比各自单独前进更可靠。
- 统计学:远观的有效性建立在统计推断的纪律之上:抽样偏差、多重比较、相关与因果的混淆,在艺术图像的量化研究中一个不少地出现。统计素养是判断"机器发现"究竟是信号还是噪声的最低门槛。
- 归属与来源:织纹匹配与统计指纹把鉴定从慧眼改成证据链,但机器仍然只能排除或提示,不能独自签发作者证书。远观圈出异常,近读与来源档案才裁决。
参考文献
- Gatys, Leon A., Ecker, Alexander S. & Bethge, Matthias. "A Neural Algorithm of Artistic Style." arXiv:1508.06576, 2015.
- Elgammal, Ahmed et al. "The Shape of Art History in the Eyes of the Machine." arXiv:1801.07729, 2018(后刊于 The Shape of Art History in the Eyes of the Machine, AAAI 会议版本).
- Arnold, Taylor & Tilton, Lauren. "Distant Viewing: Analyzing Large Visual Corpora." Digital Scholarship in the Humanities 34 (2019).
- Manovich, Lev. Cultural Analytics. The MIT Press, 2020.
- Drucker, Johanna. Visualization and Interpretation: Humanistic Approaches to Display. The MIT Press, 2020.
- van Tilborgh, Louis, Meedendorp, Teio, Hendriks, Ella, Johnson, Don H., Johnson, C. Richard, Jr. & Erdmann, Robert G. "Weave matching and dating of van Gogh's paintings: an interdisciplinary approach." The Burlington Magazine 154 (2012): 112-122.
延伸阅读
- "The Next Rembrandt" 项目技术文档与报道(ING / Microsoft / 莫瑞泰斯皇家美术馆,2016).
- Klinke, Harald (ed.). Art History and Digital Humanities(数字艺术史方法论文集).
- Bishop, Claire. "Against Digital Art History." International Journal for Digital Art History 3 (2018)(批评立场的代表文献).
- Zorich, Diane M. Transitioning to a Digital World: Art History, Its Research Centers, and Digital Scholarship. Kress Foundation 报告, 2012.